智能决策 · AI
智能决策新思路:System One 模型与大模型有何不同
原文作者 Sparkling Logic · 中文编译 上海数泱
System One 模型本质上是一种“做判断”的 AI 模型:它读取工单、日志、邮件这类杂乱的非结构化输入,从预先设定的答案集合中给出结论,并为每个答案附上表示把握程度的概率。它不取代决策管理,而是补上决策管理一直欠缺的“非结构化数据快速感知”能力;模型负责“这是什么”,业务规则负责“该怎么办”,两者配合才能做出可信的智能决策。
本文编译自 Sparkling Logic 联合创始人 Carlos Serrano-Morales 的文章(原文为第一人称)。
决策管理在非结构化数据上缺什么?
决策管理(Decision Management,DM)一直擅长决策中“深思熟虑”的部分:基于以结构化数据为主的显式逻辑,人可以阅读、测试和治理。一直存在的机会,是利用非结构化数据来增强这些自动化决策。
一类新的 AI 模型——System One 模型——正是瞄准了这一点。它作为自动化决策中常规决策管理方法的补充出现。
System One 模型是什么?
System One 模型本质上是一种“做判断”的 AI 模型。它读取杂乱的非结构化输入(如工单、日志条目或邮件),从预设的答案集合中返回答案,每个答案都带有一个概率,表示模型的把握程度。
一个理赔的例子
假设一家保险公司的理赔系统使用一个 System One 模型,设计用来回答三个问题,每个问题都有固定的可选答案:
- 理赔类型是什么?水渍损失、火灾、盗窃、责任险、其他
- 紧急程度?低、中、高
- 是否涉及第三方?否、是
理赔系统收到这样一条报案说明:
“从昨晚开始,水一直从厨房天花板渗下来。楼上邻居说是水管爆了。地板全湿了。没有人受伤。”
System One 模型处理后返回:
- 理赔类型 = 水渍损失,概率 0.93
- 紧急程度 = 高,概率 0.88
- 涉及第三方 = 是,概率 0.74
注意模型没有做什么:它不会写一段关于这笔理赔的文字,也不会对下一步该怎么办发表意见,而是交回决策可以直接使用的结构化答案。
System One 模型和大模型(生成式 AI)有什么区别?
过去三年,AI 竞赛的焦点是“写”:更像人的回答、更深的推理、更好的代码。驱动生成式 AI(GenAI)的大语言模型(LLM),无论构建、评测还是宣传,都围绕生成文本的能力。把它们用于真正的自动化决策,得到的关注则少得多。
原文作者在 DecisionCAMP '25 的“Ask an Expert”专家讨论中说过:大语言模型模拟的是语言,而不是现实;但它们太擅长让你相信并非如此,以至于很容易忘记这一点。从 DM 的角度看,生成式 AI 并不适合直接做运营决策,原因是结构性的:
- 输出自由、不一致:同样的输入,每次运行可能得到不同答案,而且答案是一段文字,决策还得再去解读。
- 置信度靠不住:大模型即使错了也显得很确定,它表达出的“自信”并不是经过测量的概率。
- 延迟和成本:逐个 token 生成文本又慢又贵,对一天要运行成千上万次的决策影响很大。这也是作者不认为机构会依赖生成式 AI 做直通式处理(straight-through processing)的原因之一。
System One 模型更接近传统机器学习模型
System One 模型走的是另一条路。它更接近 DM 已经常用、成熟的传统机器学习(ML)模型,类似零样本文本分类模型:
- 输出有边界:答案由人预先定义,决策永远不用猜模型是什么意思。
- 置信度经过校准:概率表示答案正确的可能性,而不是下一个 token 接在前一个之后的可能性。因此可以为每个问题单独设定阈值,按出错的代价来调整。
- 速度快、效率高:分类比写作快得多。
| 对比项 | 大语言模型(生成式 AI) | System One 模型 |
|---|---|---|
| 输出形式 | 自由文本,同输入可能不同答案 | 预设答案集合,结构化 |
| 置信度 | 表达出的自信不是测量过的概率 | 经过校准的概率,可按问题设阈值 |
| 速度与成本 | 逐 token 生成,慢且贵 | 分类,快且高效 |
这并不意味着 System One 模型不会出错,也不意味着它能替代生成式 AI,两者做的是不同的事。但“快、有边界、经过校准”引出一个更大的问题:这种模型到底为决策贡献了什么?什么时候可以信任它?
为什么叫 System One?
名字来自诺贝尔奖得主、心理学家丹尼尔·卡尼曼(Daniel Kahneman)。他在《思考,快与慢》(2011)中把人的认知描述为两个系统:
- 系统 1:快速、自动、不费力、靠联想。
- 系统 2:缓慢、受控、遵循规则。
系统 1 是判断的起点,是我们赖以生存的直觉或本能。它不仅启发了这类模型的名字,也启发了它们的用途。直觉很有力量,但被直觉坑过的人都知道,它不总是对的。
什么时候可以信任直觉?
系统 1 思维让我们活下来,但不一定让我们活得好。所以系统 2 充当监督者,认可或推翻系统 1 的判断。
卡尼曼和加里·克莱因(Gary Klein)在论文《Conditions for Intuitive Expertise: A Failure to Disagree》(American Psychologist,2009)中得出结论:直觉判断在满足两个条件时值得信任:
- 有效的环境:线索与结果之间存在稳定、可学习的规律;
- 学习这些规律的机会:判断者已经通过大量练习、并在快速而明确的反馈中掌握了这些规律。
他们还提醒:自信并不是准确的可靠信号。在不可预测的环境里,一个自信的判断者只是“自信地犯错”。System One 模型的置信度经过校准,但和大模型一样,仍可能过度自信。
什么时候可以信任 System One 模型?
把卡尼曼和克莱因的研究用到企业决策上,可以得到几条实用准则:
| 卡尼曼和克莱因的结论 | 对 System One 模型的含义 |
|---|---|
| 可信的直觉需要有效的环境 | 只用在线索能可靠预测结果的地方,如类别、紧急程度、意图、文档类型 |
| 可信的直觉需要学习的机会 | 需要有带标注结果数据的反馈闭环来验证模型 |
| 自信不等于准确 | 必须在自己的数据上验证校准情况,再按出错代价为每个动作设定阈值 |
换句话说,当 System One 模型满足可信直觉判断的条件,并且有一个能让“系统 2 思维”推翻其判断的机制时,才可以放心地把它用于自动化。这个机制正是决策管理的用武之地。
决策管理怎样充当“系统 2”的监督?
DM 是一门把可重复的运营决策当作资产来建模、自动化、度量和改进的学科。它的基本做法是把决策逻辑从应用代码中抽离出来,放进决策管理系统,由对决策结果负责的业务人员来管理。
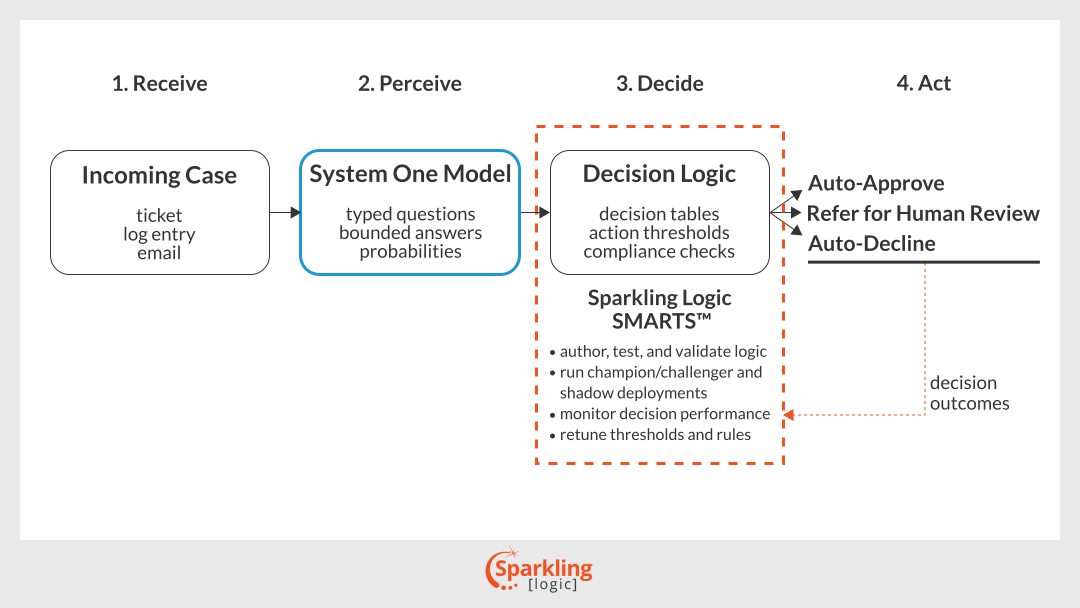
像 Sparkling Logic SMARTS™ 这样的决策管理系统结合了:
- 显式决策逻辑:决策中由人有意写下来的部分,以决策流、表格、规则等业务人员能读懂的形式表达,而不是埋在应用代码里。SMARTS™ 让分析师通过决策流、规则、表、树、图、评分卡和查找模型来建模和编写逻辑,支持图形化表达和智能体式 AI。
- 预测模型:从历史数据中学习规律,产出评分等派生信息,用于支撑决策。SMARTS™ 可以从数据中归纳规则和模型(BluePen),也可以导入并运行 Python、ONNX 和 PMML 模型。
- 质量度量:为决策的效率、公平性和可解释性给出量化数字,上线前在历史案例上度量,上线后在实际结果上度量。SMARTS™ 把历史数据放在编写过程的中心,并用决策分析(包括对已部署决策的实时分析)来度量和追踪结果。
- 测试与实验:决策上线前要测试,上线后要通过对比备选方案、按目标优化来持续挑战。SMARTS™ 支持仿真、冠军/挑战者实验和影子部署。
- 安全与治理:对关键业务决策的变更必须受控、可追溯。SMARTS™ 提供版本管理、发布管理(含云端和本地部署)、访问控制,以及用于可重复决策管理任务的工作流。
决策管理带来问责
结果是可问责的决策:每个决策都受治理、用真实数据测试、在生产中度量,并用于改进下一个版本。用卡尼曼的话说,DM 是“工业化的系统 2”——缓慢、审慎、遵循规则的思考,被做到足够快,每秒可运行数千次。
System One 模型和决策管理怎么配合?
DM 很适合充当 System One 模型所需要的系统 2 机制,因为在很多机构中,它已经在风险、信贷、产品配置等众多自动化运营决策中扮演这个角色。与其让模型来做决定,不如用它来感知杂乱输入在说什么(水渍损失,概率 0.93),再由 DM 来决定怎么做(派查勘员评估损失)。System One 模型负责感知,DM 负责政策。
回到理赔的例子。决策收到三个答案后,应用业务方编写的规则,每个问题有单独的阈值。举例来说,规则规定:理赔类型为水渍损失且概率 ≥ 0.90、紧急程度为高且概率 ≥ 0.85 时,派出查勘员。两个答案都达标,于是派出查勘员。而“涉及第三方”的概率 0.74 低于 0.80 的阈值,规则就把这笔理赔标记给理赔专员,由人确认是否涉及其他方。
这些逻辑都不在模型里,而在决策里:分析师可以阅读它、用历史理赔数据测试它,明天就能修改它。
对国内和东南亚的意义:国内和东南亚的金融、保险机构同样积累了大量客服工单、报案描述、邮件等非结构化文本。“模型只做识别、规则决定动作、阈值按风险分别设定”的分工,让这类数据进入风控和运营决策时仍然可控、可审计。
合适的架构
据原文介绍,SMARTS™ 已经具备用 System One 模型运行这个闭环、产出可信决策的架构。在理赔例子中,System One 模型作为预测模型接入,显式决策逻辑负责阈值和分派规则;质量度量追踪校准情况和实际结果;测试与实验可以回放历史理赔、通过冠军/挑战者实验逐步放量;安全与治理控制谁能改阈值、何时发布新版本。其决策智能体把运行时的各部分组合在一起:
- 负责分类和预测的机器学习模型——System One 模型就放在这个位置;
- 提供合规保障的业务规则引擎;
- 用于人工监督和漂移监控的实时监控。
AI 在决策管理中扮演哪三种角色?
System One 模型在 AI 进入 DM 的各种方式中处在什么位置?Sparkling Logic 联合创始人 Carole-Ann Berlioz 在 DecisionCAMP '26 上提出了一个有用的框架:AI 的角色正从“决策助手”向“决策架构师”演变。
- AI 作为决策助手:例如 Sparkling Logic 的 AI Assistant,帮助业务分析师使用决策管理系统,起草、验证和解释决策逻辑,完成开发阶段的其他任务。错误是局部的,可以在测试中发现。
- AI 作为决策架构师:Carole-Ann 认为这不只是功能升级,而是风险类别的变化。当 AI 被授权编写整个决策模型并自行解决冲突时,错误会变成系统性的,且难以发现。此外,当 AI 对不完整的需求套用统计上“典型”的假设时,结果可能是正确的,却缺少让机构保持竞争优势的那些独有规则。
预测型 ML 模型和 System One 模型解决不了决策架构师角色的难题,但它们指向了 AI 在 DM 中的第三种角色:运行时顾问。按设计使用时,它们为决策提供建议,而决策仍由人掌控。
| AI 角色 | 作用时点 | 做什么 | 风险特征 |
|---|---|---|---|
| 决策助手 | 设计阶段 | 起草规则、解释逻辑、生成测试,由人审核 | 可控:错误是局部的,测试能发现 |
| 决策架构师 | 设计阶段 | 自行编写整个决策模型并解决冲突 | 系统性:错误在数百条规则中涌现,难以解释 |
| 运行时顾问 | 执行阶段 | 提供额外上下文,辅助由人设计的决策 | 有边界:错误受答案结构、按动作设定的阈值和周边规则约束 |
规则挖掘、预测模型和 System One 模型怎么选?
如果角色是运行时顾问,下一个问题就是请哪位“顾问”。在人无法自己写出规则的情况下,机构现在有三种做法:
| 对比项 | 规则挖掘 | 建预测模型 | 用 System One 模型 |
|---|---|---|---|
| 生产中运行的是什么 | 从数据和专家经验中学到的可读规则 | 作为决策一部分被调用的模型 | 作为决策一部分被调用的模型 |
| 最适合的输入 | 结构化历史记录 | 通常是数值型结构化数据 | 非结构化文本:备注、工单、邮件 |
| 解释方式 | 逐条规则解释,部署前可审核 | 给出答案及相关统计信息,可能附原因码 | 每个答案一个概率;原因不是可追踪的轨迹 |
| 如何变化 | 分析师编辑或重新挖掘规则时 | 用新数据重训或自适应重训 | 模型版本变化时 |
三者有重叠,选哪种取决于具体情况。规则挖掘适合结构化、受监管、每个结果都必须站得住脚的决策;预测模型从结构化数据中补充上下文,System One 模型则从非结构化数据中补充上下文。它们并不互斥,三者可以用在同一个决策里。
在 SMARTS™ 中,BluePen 可以挖掘规则、创建预测模型,还能计算差异影响(disparate impact)、SHAP 等公平性和可解释性指标,帮助确保决策站得住脚。也正是出于这个原因,决策中有些部分无论模型多好,都不应该交给模型。
哪些部分必须保持显式规则?
无论机构采用哪种做法,无论模型变得多快多便宜,决策中有些部分都应保持显式:
- 授权与权限:例如账户是否存在、谁可以审批、是否已记录同意。
- 监管逻辑:一组规则或一张决策表,严格按人写下的内容执行,可以逐行展示给监管机构,只有人编辑时才会改变。贷款中的拒绝原因说明(adverse-action reasons),以及费率备案下的资格和定价规则,都属于这一类。
- 不可逆的动作:付款、注销、生产变更等,不论模型置信度多高,都需要显式的把关。
- 机构差异化的判断:Carole-Ann 的观点在运行时同样适用。那些让一家机构的决策与众不同的“非显而易见”的规则,应该被写下来、有人负责,而不是隐含在一个通用模型里。
如何落地 System One 模型?
对已经在用决策管理系统的机构来说,引入 System One 模型和给现有决策增加一个新策略差别不大。作者建议的步骤是:
- 选对决策:选一个满足卡尼曼和克莱因可信条件的决策——量大、线索与结果之间关系稳定、结果数据可以标注。
- 让模型只做感知,不做政策:模型只回答“这是什么”,业务规则回答“我们该怎么办”。
- 先决策、不立即执行:让新策略(System One 模型 + 业务规则)以影子模式与现有策略并行运行,在真实案例上对比结果。
- 在自己的数据上检查校准:在设定任何阈值之前,先确认模型给出的概率与实际观察到的准确率相符。
- 谨慎自动化:只开放低风险、可逆的分支,并按动作设定阈值。例如,设置一个冠军/挑战者实验,让 10% 的决策在 7 天内走新策略,加一道人工复核来验证这些决策,再慢慢放量。
- 持续监控,判断何时重新评估:关注更正率上升、模型漂移和政策更新,发生重大变化时应触发重新校准。
System One 模型会如何影响决策管理?
结论是:System One 模型现在不会、将来也不会取代决策管理。它提供 DM 一直欠缺的、对非结构化数据的快速感知;DM 则提供受治理的政策,让这些判断可以放心地付诸行动。两者结合,可以实现值得信任的自动化决策。
作者的建议是从小处着手:选一个决策,给模型一个感知任务,以影子模式运行,让你自己的数据告诉你下一步怎么做。