智能决策 · AI · 行业大会
预告|DecisionCAMP 2026 演讲要点:Sparkling Logic 谈从 AI 助手到 AI 决策架构师的风险与护栏
原文作者 Sparkling Logic · 中文编译 上海信数
预告:这是 Sparkling Logic 联合创始人兼首席产品官(CPO)Carole-Ann Berlioz 在 DecisionCAMP 2026 演讲的要点预告。本文先整理演讲的主要观点和中文配图,中文版 slides(PDF)附在文末,完整解读将于后续发布。
本文根据 DecisionCAMP 2026 议程页和 Carole-Ann Berlioz 的原版 slides(PDF)编译。
DecisionCAMP 是决策管理(Decision Management)领域的行业会议。2026 年会议于 8 月 25 日至 28 日举行,议程按美国东部夏令时(EDT)排期。8 月 25 日 14:00 EDT(北京时间 8 月 26 日 02:00),Sparkling Logic 联合创始人兼首席产品官(CPO)Carole-Ann Berlioz 做了题为 From Assistant to Architect: The High-Stakes Leap to AI-Driven Decision Models(从助手到架构师:迈向 AI 驱动决策模型的高风险一跃)的分享。来源
她的核心观点是:把生成式 AI 接入决策管理系统,从"AI 助手"升级为"AI 决策架构师",变的是风险类别,不只是多了一项功能。来源
1. 自主权是怎么一步步"溜进来"的?
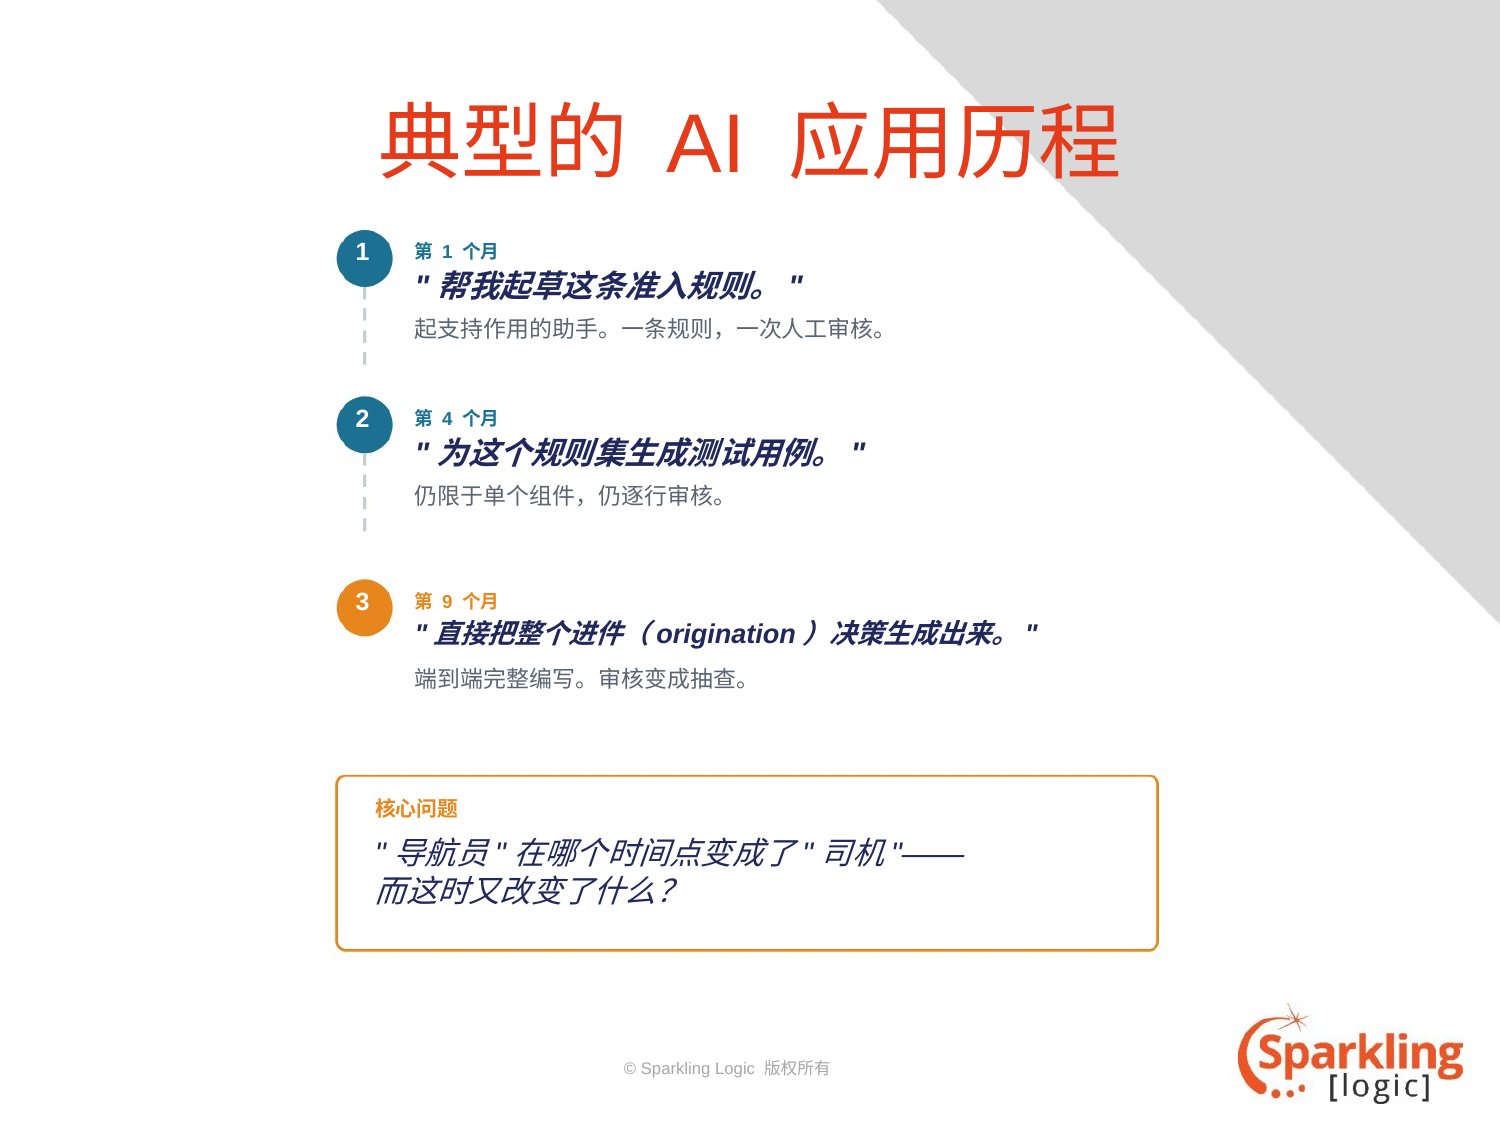
slides 用一段典型的使用历程说明这个变化,演讲把它描述为"在没人做出治理决定的情况下,自主权悄悄增加":来源
- 第 1 个月:"帮我起草这条准入规则。"AI 只是辅助,一条规则,一次人工审核。
- 第 4 个月:"为这个规则集生成测试用例。"仍然限于单个组件,仍然逐行审核。
- 第 9 个月:"直接把整个进件(origination)决策生成出来。"AI 端到端编写,人工审核变成了抽查。
她提出的核心问题是:AI 从"导航员"变成"司机"发生在哪个时间点?那一刻变的又是什么?来源
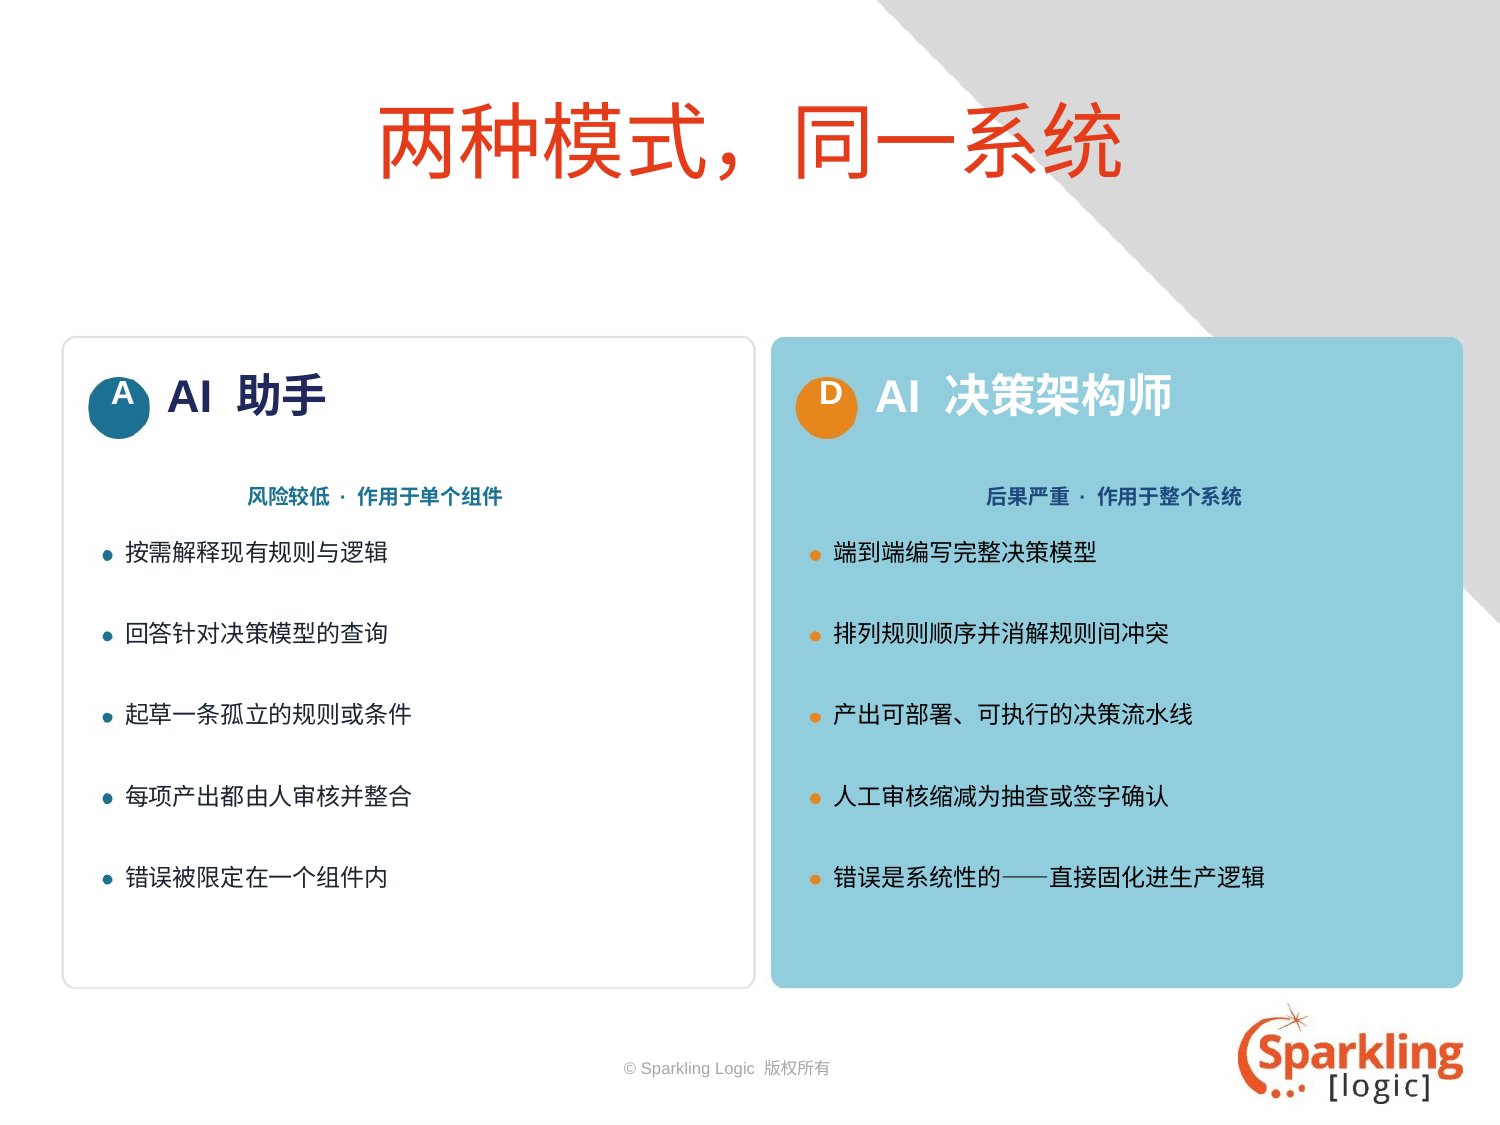
2. AI 助手和 AI 决策架构师有什么区别?
| AI 助手(AI Assistant) | AI 决策架构师(AI Decision Architect) | |
|---|---|---|
| 风险定位 | 风险较低,作用于单个组件 | 后果严重,作用于整个系统 |
| 典型工作 | 按需解释现有规则和逻辑;回答针对决策模型的查询;起草一条孤立的规则或条件 | 端到端编写完整决策模型;排列规则顺序并消解规则冲突;产出可部署、可执行的决策流水线 |
| 人工角色 | 每项产出都由人审核并整合 | 人工审核缩减为抽查或签字 |
| 出错后果 | 错误限定在一个组件内 | 错误是系统性的,直接固化进生产逻辑 |
3. 为什么需求梳理仍应由人主导?
slides 列了四个理由:来源
- 隐性知识没写下来:做了 20 年的核保人员往往说不清自己的经验法则,要靠灵活的、基于场景的访谈挖出来。这是需要技能的人类活动,不是检索任务。
- 需求本身带有"政治性":合规、法务、销售、精算等干系人对同一条规则要的东西不一样,梳理需求要读懂信任和权力关系,不是汇总各方表态。
- 发现"未知的未知":好的需求分析师会追问自己踩过坑的场景,靠的是实际运营留下的教训,不是训练数据里的统计概率。
- 没说出口的东西:未明说的风险偏好、竞争定位、"大家都心照不宣"的法律风险,都会影响需求,但只看输入文字的模型看不到。
她的结论是:需求梳理不完整时,AI 决策架构师不会留下看得见的空白,而是用"统计上最典型"的假设把它填上。所以这个角色不会被削弱,反而更关键。来源
4. 放手让 AI 自主编写,会出什么问题?
slides 归纳了四类风险:来源
- 失去整体验证:每条规则单独看都对,组合起来仍可能得出错误决策,比如条件冲突、分支永远走不到、优先级出错却不报错。AI 助手不需要跨规则推理,AI 决策架构师必须做到,而现有工具大多无法检查它是否做到了。
- 可解释性"赤字":人写的模型每条规则都有可追溯的理由;模型生成的流水线可能是在优化一个无法逐条拆解的目标函数,你得到的是答案,不一定是站得住的理由。
- 测试范围爆炸:验证一条起草的条款可行,验证数百条相互作用的 AI 生成规则的涌现行为,是大多数 QA 流程从未设计过的组合问题。
- 问责问题:全自主流水线做出错误决定时,比如错误拒绝或定价错误的保单,谁对结果负责?事后能否说清它是怎么发生的?
5. 为什么 AI 生成的逻辑会削弱竞争优势?
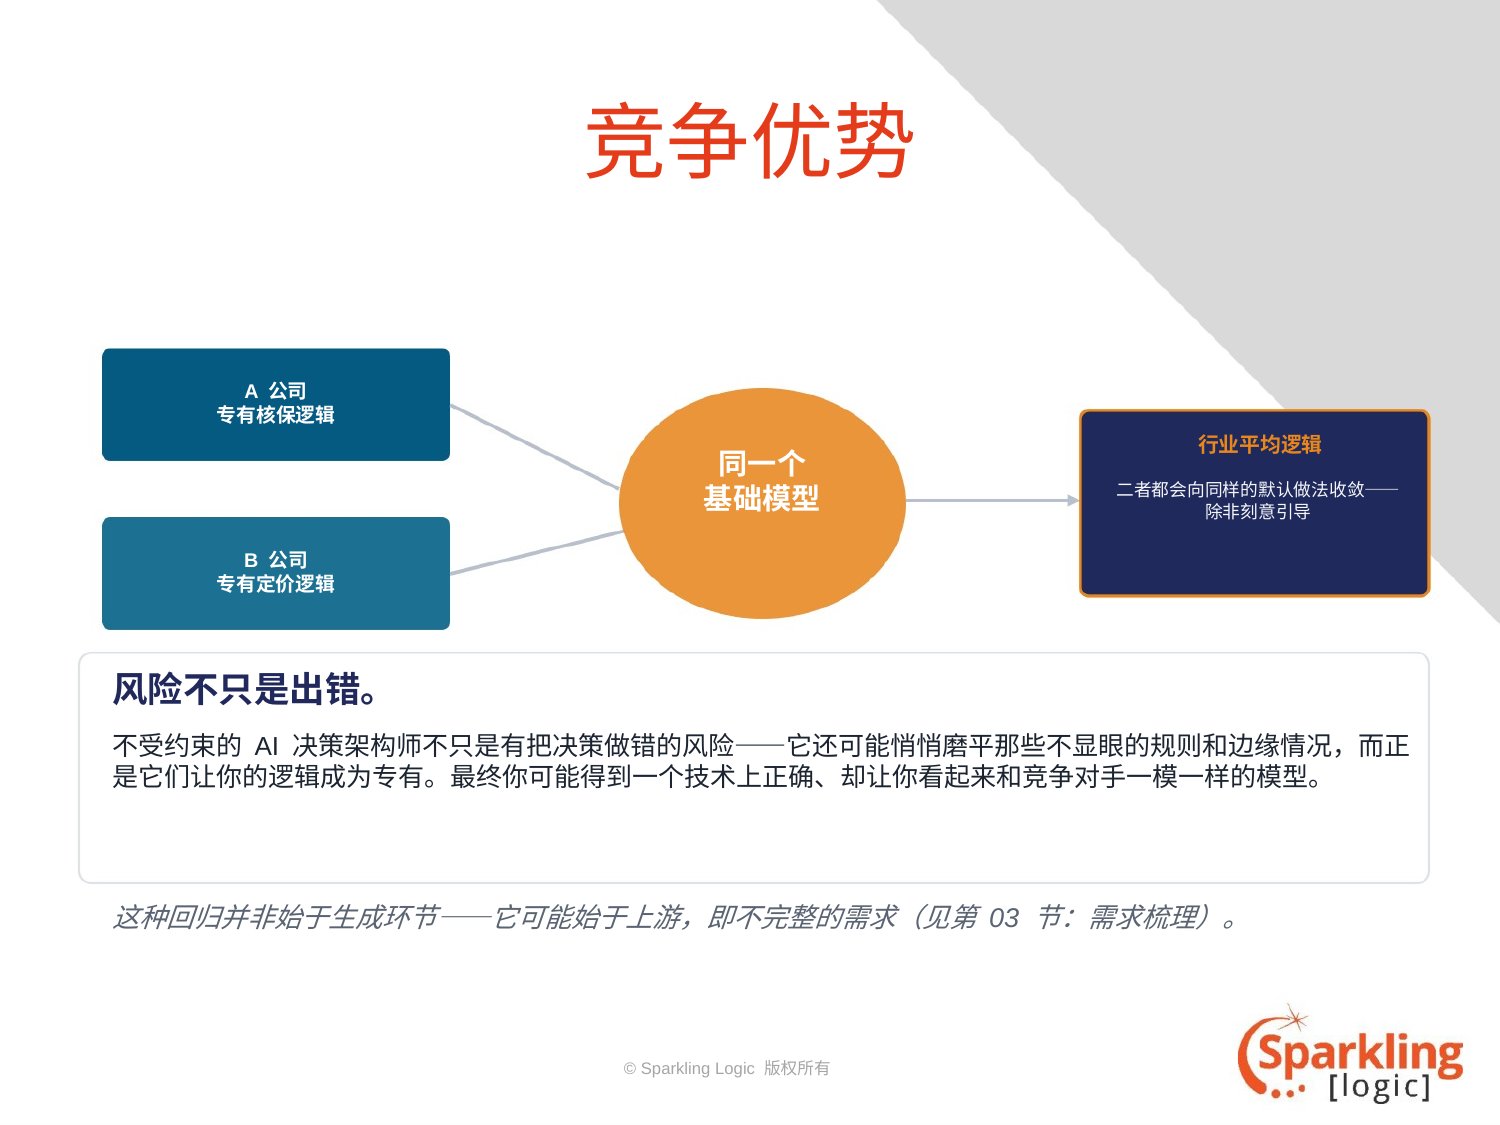
议程摘要指出一个战略悖论:专有决策逻辑往往是企业最主要的差异化来源,而 AI 模型天然趋向优化"行业平均"。来源
slides 的示意是:A 公司有专有核保逻辑,B 公司有专有定价逻辑,二者都基于同一个基础模型,如果不刻意引导,会一起向同样的默认做法收敛。风险不只是出错:不受约束的 AI 决策架构师可能悄悄磨平那些不显眼的规则和边缘情况,而它们恰恰是你的逻辑之所以专有的原因。最终可能得到一个技术上正确、却让你看起来和竞争对手一模一样的模型。这种"向行业均值回归"甚至可能在生成之前,就因需求梳理不完整而开始。来源
6. 现有架构还缺什么?
slides 列出四个缺口:来源
- 没有整体验证标准:多数验证工具只检查语法或单条规则逻辑,不检查生成时规则之间的涌现交互;即便能查,业务方也很少把 KPI 预期写成文档。
- 出处缺口(Provenance Gap):难以追溯一条模型生成的规则为什么存在、由哪个训练模式或提示上下文驱动,审计和监管应对因此困难。而当追溯和可解释工具替人做了这件事,风险又变成业务方"偷懒",不再质疑 AI 生成的逻辑。
- 漂移监控缺口:决策模型可能在多轮 AI 辅助编辑中退化或被悄悄覆盖。现在有针对资产文件的版本对比(diff),却几乎没有针对"决策语义"的对比;就算有,业务方会关注吗?
- 激励错位:当前生成式 AI 工具优化的是"看起来合理、流畅"的输出,而不是保留某个组织特有的、不显眼的竞争逻辑。
她强调,问题不只是工具缺口,使用方式也必须同步演进。来源
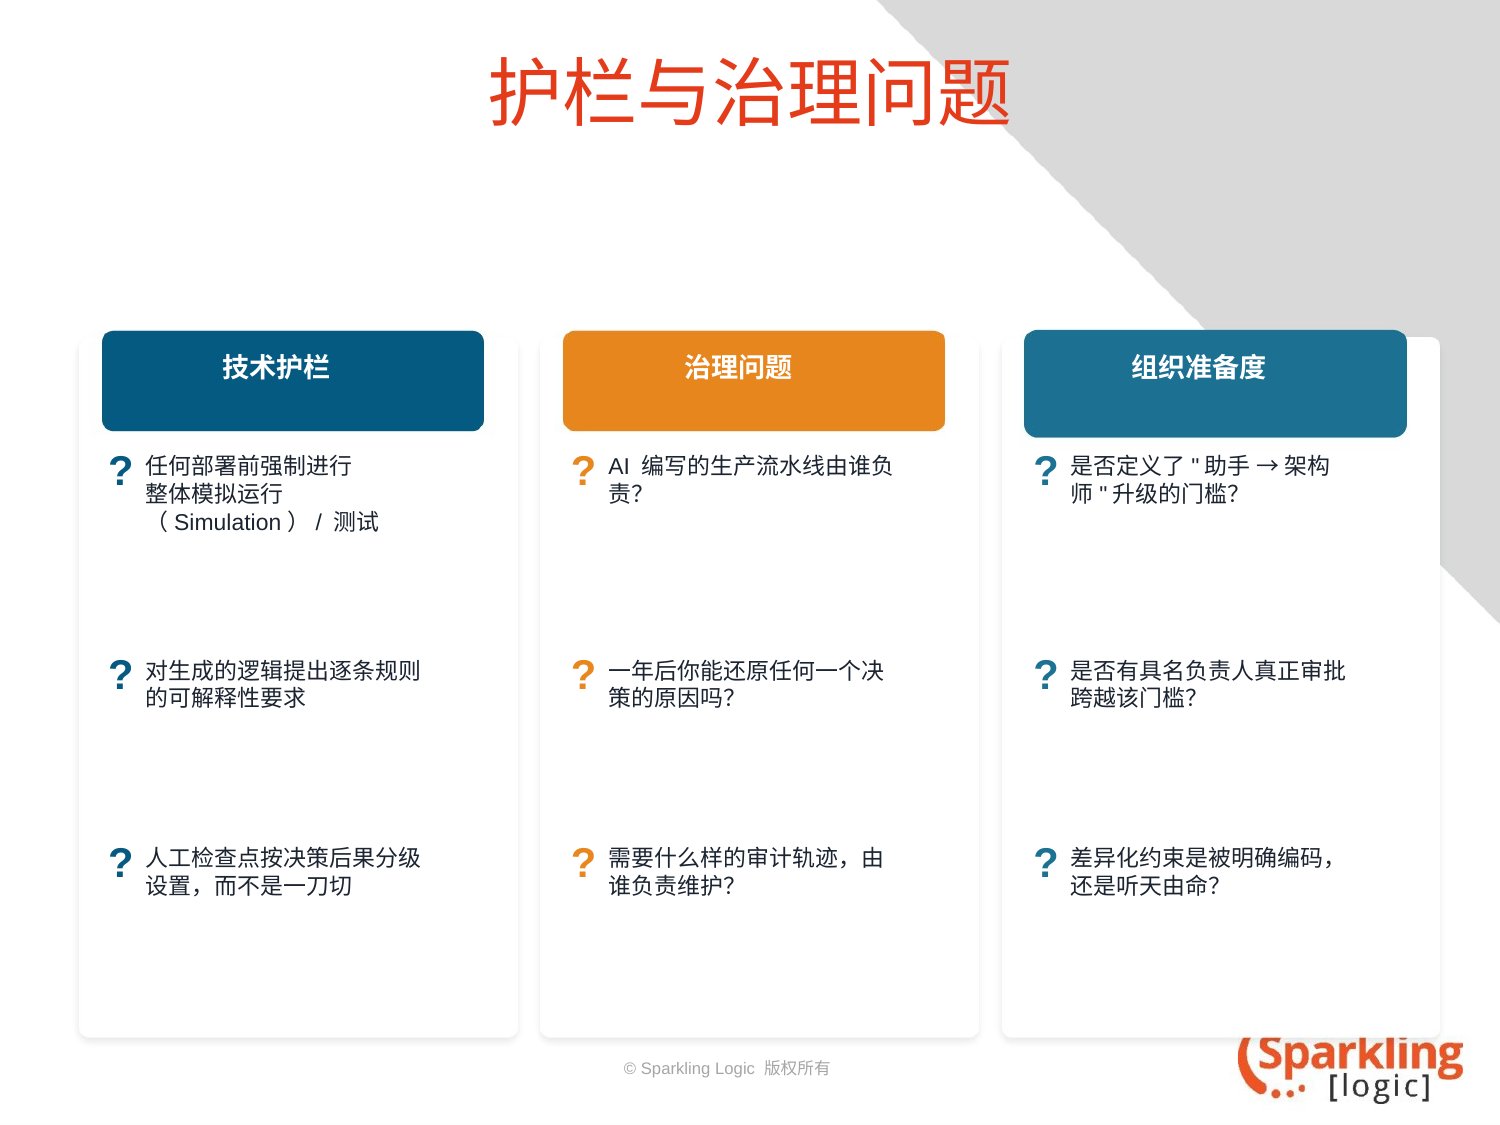
7. 把"引擎室钥匙"交给 AI 之前要回答哪些问题?
| 技术护栏 | 治理问题 | 组织准备度 |
|---|---|---|
| 任何部署前,强制进行整体模拟运行(Simulation)与测试 | AI 编写的生产流水线由谁负责? | 是否定义了"助手 → 架构师"升级的门槛? |
| 对生成逻辑提出逐条规则的可解释性要求 | 一年后能否还原任何一个决策的原因? | 是否有具名负责人真正审批跨越该门槛? |
| 人工检查点按决策后果分级设置,而不是一刀切 | 需要什么样的审计轨迹,由谁维护? | 差异化约束是否被明确编码,还是听天由命? |
来源:slides
结语:引擎室还没准备好"自动驾驶"
Carole-Ann Berlioz 的收尾观点是:从助手到架构师的跃迁是风险类别的变化,应在规划和治理中按这个级别对待,而不是当作"顺理成章的下一个版本"。她呼吁决策管理社区共同建立标准,包括整体验证、出处追溯、差异化保留,而不只靠各厂商各自的方案。她留给听众一个问题:"你的决策逻辑里,哪一条规则是你绝不希望被 AI '平均掉'的?" 来源
对正在规则引擎或智能决策平台中引入生成式 AI 的团队,这些问题可以直接用作内部评审清单。
以上是演讲要点预告,完整解读将于后续发布。
Sparkling Logic SMARTS 中国服务商:上海信数。